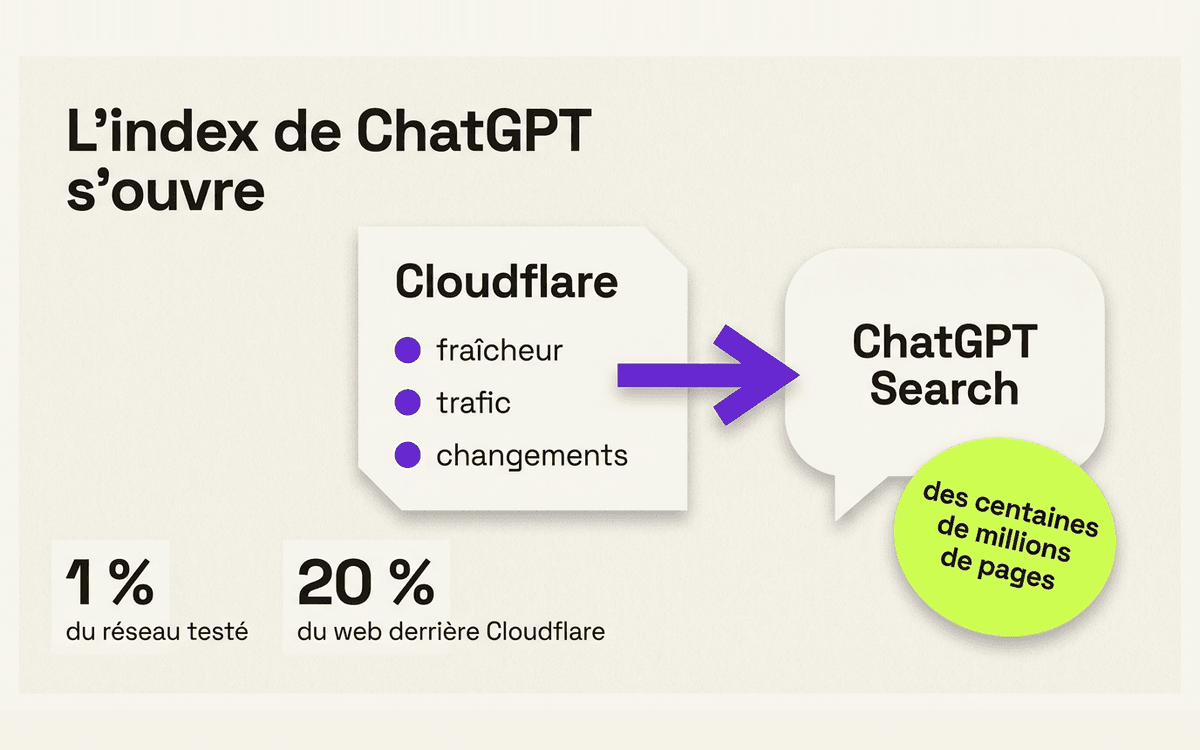
Une page jamais crawlée n'existait pas pour ChatGPT. Peu importe sa qualité, peu importe le travail derrière. Le 15 octobre 2026, Cloudflare et OpenAI publient les résultats d'un pilote de recherche lancé en juillet : des centaines de millions de pages nouvelles sont entrées dans l'index de ChatGPT Search. Pas par un changement d'algorithme. Par l'infrastructure.
pages web nouvelles indexées (blog Cloudflare, 15/10/2026)
du web se trouve derrière le réseau Cloudflare (communiqué du 08/07/2026)
Ce que Cloudflare a fait avec OpenAI
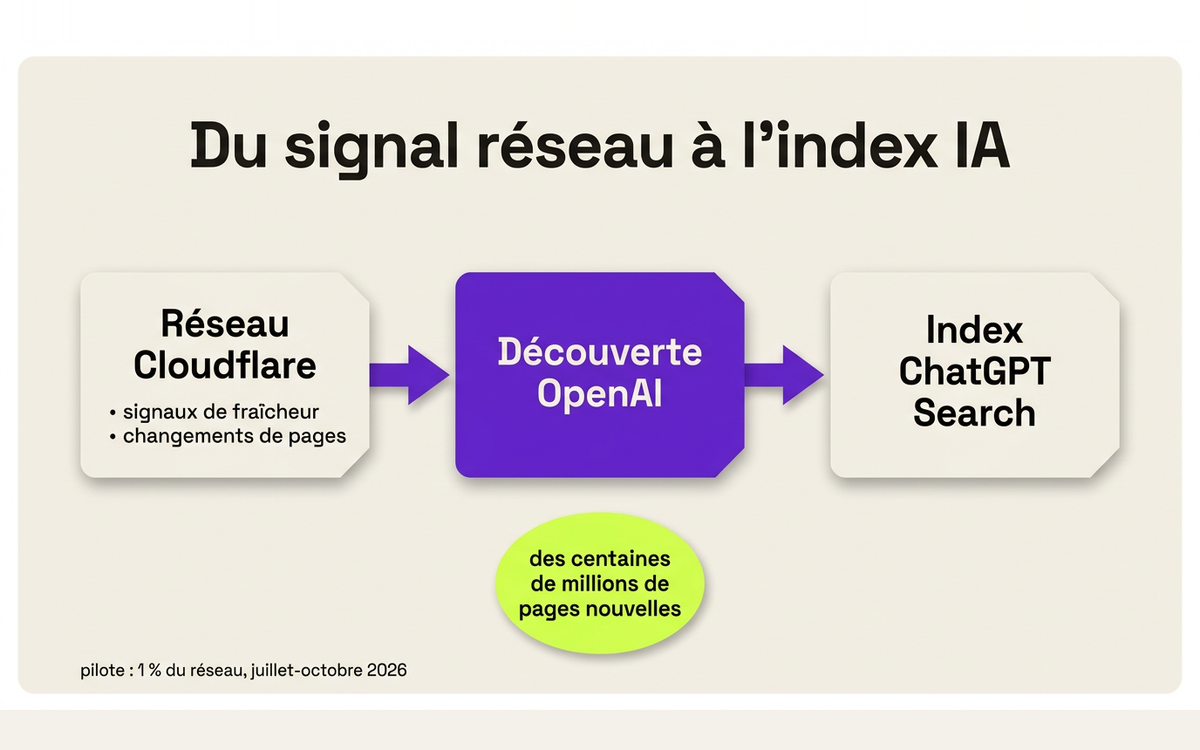
Le 8 juillet 2026, Cloudflare annonce un pilote de recherche avec OpenAI. Une cohorte de sites représentant environ 1 % de son réseau participe. Le principe : le réseau Cloudflare transmet à OpenAI des signaux sur les pages qu'il sert. Leur fraîcheur, la qualité du trafic qui les touche, les changements réellement intervenus sur la page.
Le 15 octobre, les deux entreprises publient les premiers résultats dans un post co-signé. Le pilote a permis à OpenAI de découvrir et indexer des centaines de millions de pages que son crawler ne connaissait pas. Le même post décrit l'autre face du travail : filtrer ce qui ne mérite pas un crawl. Bots qui demandent des fichiers inexistants, sites qui redirigent presque toute adresse vers la homepage, copies du même contenu. Et des signaux pour repérer une page compromise, un faux formulaire de login posé par un attaquant, sans pénaliser tout le domaine.
Pourquoi c'est une bascule pour la visibilité IA
La découverte classique fonctionnait par les liens et le crawl. Un moteur devait croiser des liens pour deviner qu'une page existe, puis aller la chercher. Une page isolée, sur un site récent, sans liens entrants solides, restait hors de portée. Vous pouviez publier le meilleur guide d'installation de votre secteur : si personne ne le reliait, ChatGPT ne le savait pas.
Le point d'entrée change de nature. L'infrastructure sait qu'une page existe avant même qu'un crawler s'y intéresse. Elle sait quand la page change, si le trafic est humain, si le contenu a été modifié. Cloudflare écrit le contraire d'un cliché tenace : optimiser votre site pour l'IA ne sert à rien si l'IA ne peut pas le trouver. La découverte devient la première étape de la visibilité générative, et elle ne se joue plus uniquement dans les liens.
Pour un dirigeant, la conséquence est directe. Votre contenu peut entrer dans le champ des réponses IA sans budget de netlinking. Mais une condition reste entière, et c'est là que beaucoup vont se tromper.
La limite qui compte : découverte, pas classement
Les signaux Cloudflare font exister une page dans l'index. Ils ne la positionnent pas. Le post est clair : OpenAI évalue et classe les pages de manière indépendante, selon leur pertinence et leur utilité. La découverte vous ouvre la porte du tournoi. Elle ne vous fait pas gagner de match.
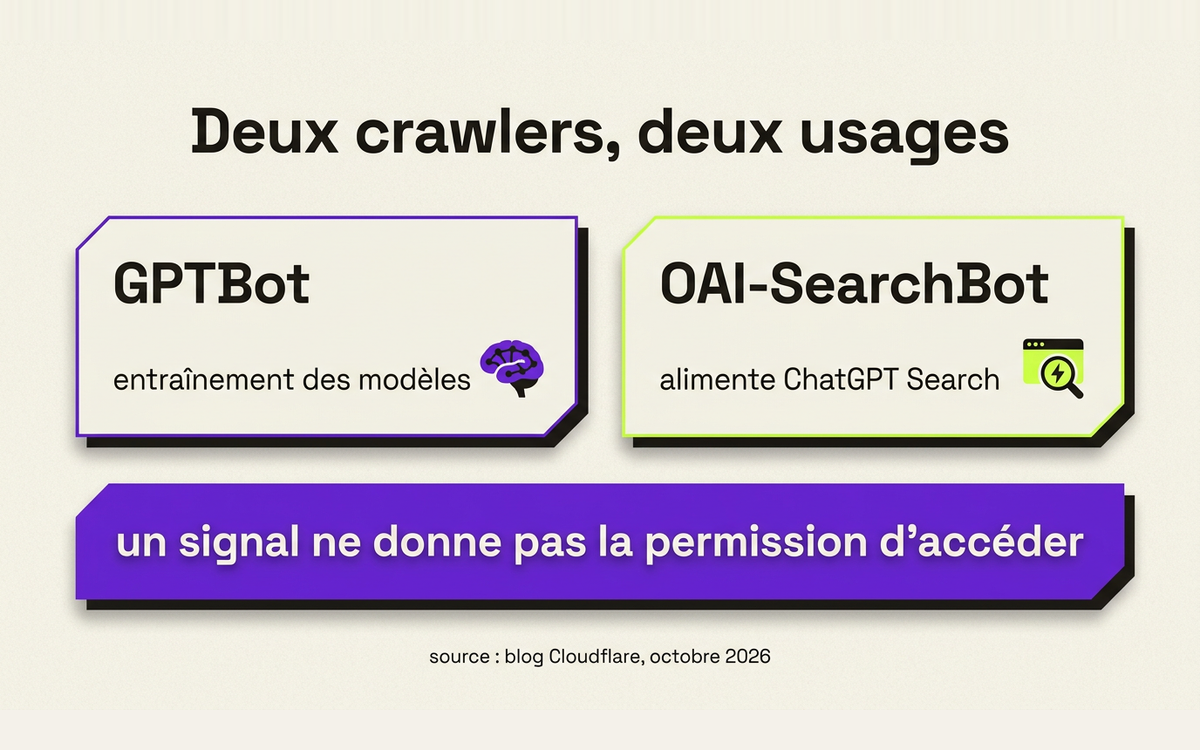
Deuxième limite, encore plus nette. Cloudflare l'écrit en une phrase : « A signal about a page doesn't grant permission to access it. » Un signal d'existence ne donne pas le droit de crawler la page. Le pilote transporte des métadonnées de découverte, pas le contenu des pages pour l'entraînement des modèles. La nuance compte, parce que deux crawlers coexistent chez OpenAI : OAI-SearchBot, qui alimente ChatGPT Search, et GPTBot, qui collecte du contenu pouvant servir à l'entraînement. Search Engine Journal relève que si les deux sont autorisés, OpenAI peut réutiliser les données collectées pour les deux usages.
Ce que ça change pour votre site
Premier chantier, le contrôle. Vos règles robots.txt et l'outil AI Crawl Control de Cloudflare décident de ce que les crawlers IA peuvent toucher. Bloquer OAI-SearchBot, c'est disparaître de l'index de ChatGPT Search pour une ligne de configuration. Autoriser les deux crawlers, c'est accepter les deux usages. Ce choix vous appartient. Encore faut-il l'avoir fait en connaissance de cause.
Deuxième chantier, la fraîcheur. Les signaux de changement décident quand une page mérite un nouveau passage. Un site qui ne bouge plus donne moins de raisons de revenir. Publier, mettre à jour, corriger : ces gestes deviennent des signaux de crawl, pas seulement des arguments éditoriaux.
Vérifiez votre robots.txt
OAI-SearchBot et GPTBot présents ? Bloqués ? Cinq minutes de lecture, une conséquence directe sur votre présence dans ChatGPT Search.
Contrôlez AI Crawl Control si vous êtes chez Cloudflare
Le réglage par catégorie de crawler IA existe, à aligner avec votre politique de contenu.
Testez ce que ChatGPT dit déjà de vous
Posez vos requêtes d'achat à ChatGPT. Regardez qui est cité, qui est absent, quelle page de votre site ressort.
Troisième point, et le plus important : être indexé n'est pas être cité. Le classement reste indépendant, et la citation se gagne ailleurs. Sur un consensus clair, des entités identifiables, des données structurées qui disent ce que vous êtes. C'est le cœur du travail de visibilité IA : la page existe désormais, reste à ce que l'agent la choisisse quand il répond.
Le piège à éviter
Entrer dans l'index par la porte de l'infrastructure ne remplace rien. Sans contenu citable, sans entité nette, sans structure lisible par les modèles, votre page existera dans un index sans y être jamais appelée. L'indexation est la condition d'entrée. La citation est le vrai combat.
Comment on travaille ce sujet
Le référencement IA se joue maintenant sur deux plans : exister dans les index (crawl, fraîcheur, technique) et être retenu par les modèles (consensus, entités, données structurées). Le pilote Cloudflare-OpenAI renforce le premier plan. Il ne décrète rien sur le second.
Ma méthode GAM part d'un audit de visibilité : cartographier où vous êtes cité et où vous êtes absent dans les réponses IA, sur vos requêtes d'achat. Ensuite seulement, on décide de quoi corriger : contenu citable, signaux d'entité, structure. Le référencement IA et le travail sur les sources citées s'assemblent avec ces fondations techniques. Ce pilote en change le contexte, pas les fondations.
Ce qu'il faut retenir
Des centaines de millions de pages nouvelles sont entrées dans l'index de ChatGPT Search grâce aux signaux du réseau Cloudflare, sur une cohorte de 1 %. La découverte ne dépend plus uniquement des liens : l'infrastructure compte désormais. Par contre, le classement reste indépendant, un signal ne donne pas la permission d'accéder, et l'entraînement reste distinct de la recherche. Votre contrôle vit dans le robots.txt et dans AI Crawl Control. Le reste, exister puis être cité, se construit.
Questions fréquentes
Cloudflare envoie-t-il le contenu de mes pages à OpenAI pour l'entraînement ?
Non. Le pilote transporte des métadonnées de découverte : existence, fraîcheur, changements, qualité du trafic. Cloudflare précise que le contenu des pages ne sert pas l'entraînement dans ce cadre. Le crawl des pages elles-mêmes reste soumis à vos règles robots.txt.
Je ne suis pas hébergé chez Cloudflare, ça me concerne quand même ?
Oui. Le pilote montre une évolution de méthode : le crawl devient piloté par des signaux réseau plutôt que par la seule exploration de liens. D'autres acteurs de l'infrastructure peuvent suivre le même chemin. Et quel que soit votre hébergeur, vos règles robots.txt restent le contrôle qui décide de votre présence dans ChatGPT Search.
OAI-SearchBot et GPTBot, quelle différence ?
OAI-SearchBot alimente ChatGPT Search, le moteur de recherche d'OpenAI. GPTBot collecte du contenu qui peut servir à l'entraînement des modèles. Search Engine Journal indique qu'autoriser les deux permet à OpenAI de réutiliser les données collectées pour les deux usages. Deux décisions distinctes, deux conséquences distinctes.
Être indexé par ChatGPT garantit-il d'être cité ?
Non. Le classement des pages reste indépendant chez OpenAI, et la citation dépend de la pertinence et de l'utilité perçue de votre contenu. L'indexation est la condition d'entrée dans le tournoi. Être retenu dans la réponse demande un contenu qui fait consensus, des entités claires et une structure lisible par les modèles.
Comment savoir si ChatGPT cite déjà mon site ?
Testez vos requêtes d'achat les plus rentables sur ChatGPT, Perplexity et les AI Overviews de Google. Notez qui est cité, qui est absent, et quelle page ressort quand vous l'êtes. Une cartographie complète de ces citations et absences, sur l'ensemble de vos requêtes commerciales, fait partie de l'audit de visibilité IA.